1994выпуск C011-3
Построение двойного экспоненциального среднего из компенсации лага
На безышумовом линейном ряде, достигшем установившегося режима, удвоенное первое экспоненциальное среднее минус второе восстанавливает исходный ряд в каждом временном индексе. Формальные начальные значения из свободного члена и наклона линейной регрессии делают это совпадение точным; начальное значение по первому наблюдению — нет.
- На безышумовом точном линейном ряде, уже достигшем установившегося режима, удвоенное первое экспоненциальное среднее минус второе восстанавливает исходный ряд в каждом временном индексе.
- На разобранном линейном ряде оба экспоненциальных средних — прямые, параллельные данным, каждое запаздывает на один и тот же лаг в 5 интервалов дискретизации.
- Формальные начальные значения из свободного члена и наклона линейной регрессии заставляют построенный ряд совпасть с линейными данными, а начальное значение по первому наблюдению — нет.
- Короткая выборка в паре с длинным окном делает начальное значение по первому наблюдению менее точным, поэтому построение не следует оценивать на первых двух окнах, если ранний отрезок не является предметом изучения.
Тождество на линейном ряде
Двойное экспоненциальное среднее — это построенный ряд, равный удвоенному первому экспоненциальному среднему минус второе экспоненциальное среднее от этого первого среднего. Экспоненциальное сглаживание — рекурсивный сглаживатель, который смешивает новейшее наблюдение с предыдущим сглаженным значением через константу alpha. На безышумовом точном линейном ряде, уже достигшем установившегося режима, удвоенное первое экспоненциальное среднее минус второе экспоненциальное среднее восстанавливает исходный ряд в каждом временном индексе.
Разобранное построение
Разобранное линейное построение использует свободный член 25, наклон 5, окно 11, константу сглаживания 0.167 и лаг одного среднего в 5 интервалов дискретизации. Константа сглаживания — это alpha, определяемая как два, делённые на единицу плюс окно усреднения. Лаг — это сдвиг по времени экспоненциального среднего на линейном ряде, равный единице минус alpha, делённой на alpha, либо половине единицы, меньшей окна.
На этом линейном ряде оба экспоненциальных средних — прямые, параллельные данным. Первое запаздывает на один лаг, а второе запаздывает ещё на один лаг того же размера.
Как два лага компенсируют друг друга
Скользящее среднее — сглаживатель по ретроспективе, чьё окно задаёт и отзывчивость, и лаг, который второму сглаживателю предстоит компенсировать. В линейной модели первое экспоненциальное среднее равно ряду минус наклон, умноженный на лаг, а второе равно первому минус наклон, умноженный на лаг. Эта пара перестраивается в тождество двойного экспоненциального среднего.
Редакторское: читайте второй сглаживатель как оценку смещения первого сглаживателя на локально линейном ряде. Возврат этого оценённого смещения и есть само построение, а не последующая проверка фильтра.
Инициализация и начальные значения
Инициализация — это стартовые значения, выбранные для двух рекурсивных средних до выхода на установившийся режим. Формальные начальные значения берутся из свободного члена и наклона линейной регрессии на подмножестве выборки. Линейная регрессия — подгонка прямой, чей свободный член и наклон дают формальные начальные значения для двух вложенных экспоненциальных средних. Эти начальные значения заставляют построенный ряд совпасть с линейными данными, а начальное значение по первому наблюдению — нет.
При начальном значении по первому наблюдению первое экспоненциальное среднее по-прежнему запаздывает на 5 интервалов, а второе — на 10. Двойное экспоненциальное среднее запаздывает примерно на один интервал в момент времени, равный окну, и не показывает значимого лага после двух окон.
На двух окнах линейный ряд равен 135, а построение с начальным значением по первому наблюдению равно 133.34, ошибка восстановления составляет -1.2 процента. В конце выборки значения равны 230 и 229.903.
Первые два окна
Короткая выборка в паре с длинным окном делает начальное значение по первому наблюдению менее точным, поэтому построение не следует оценивать на первых двух окнах, если ранний отрезок не является предметом изучения.
EMA1 и EMA2 запаздывают относительно линейного ряда без шума на одно и два окна
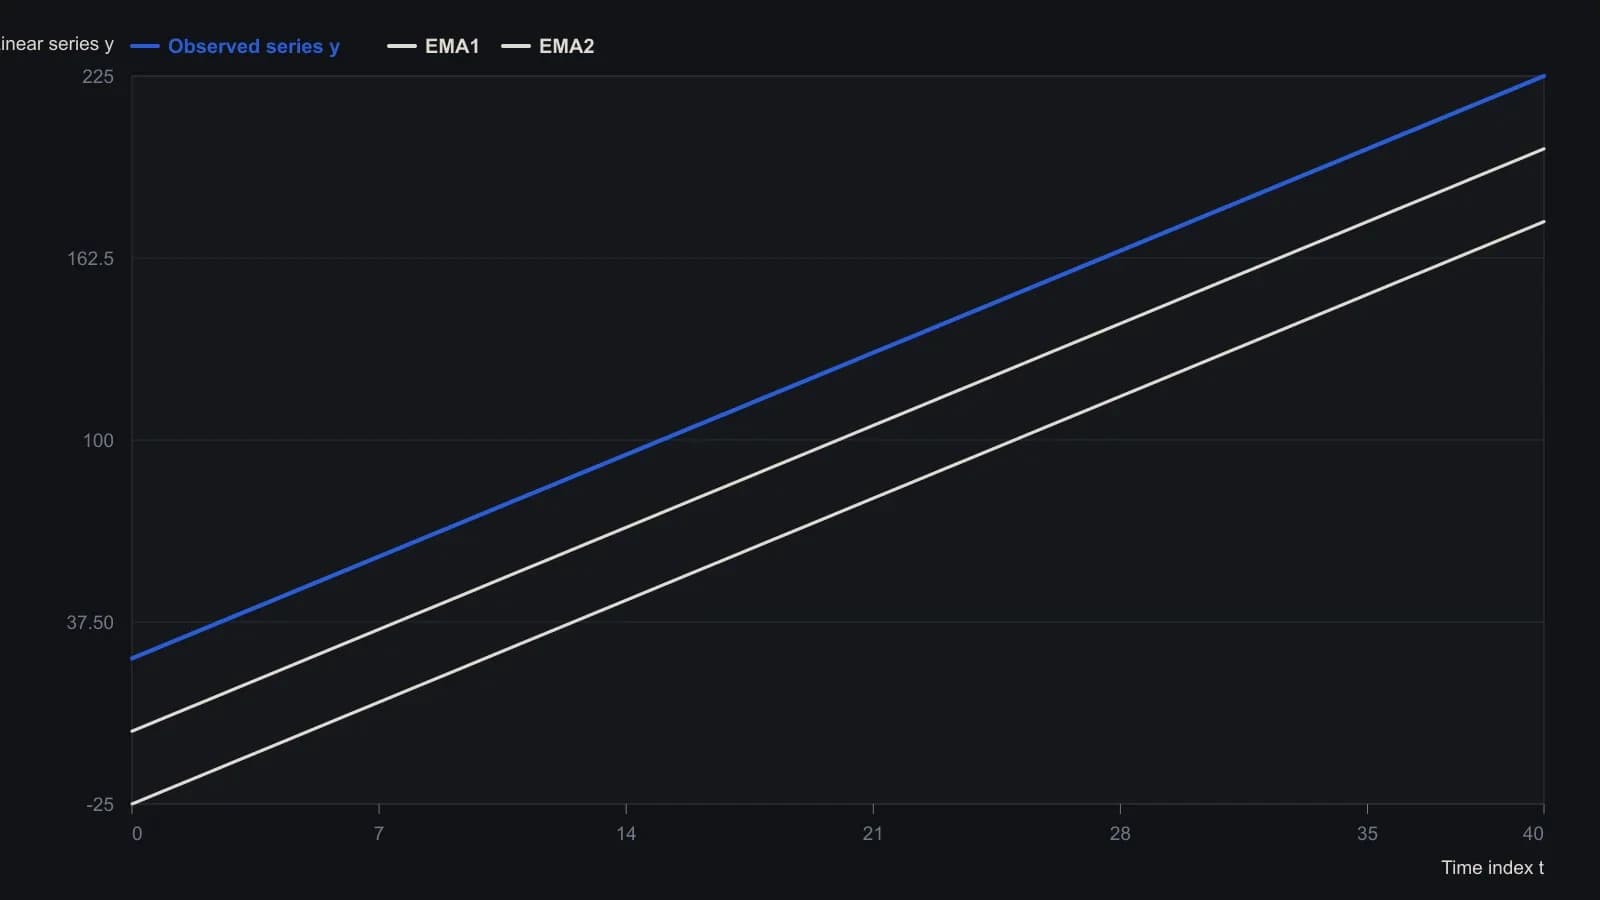
Боковая панель предполагает отсутствие шума и i > w. Окно w = 11, поэтому α = 2/(w+1) = 1/6, а запаздывание L = (w−1)/2 = 5. Формальные начальные значения: EMA1 при t = 0 ≈ 0 и EMA2 при t = 0 = −25, из свободного члена a = 25 и наклона b = 5. При этих начальных значениях EMA1(t) = 5t и EMA2(t) = 5t − 25 точно, поэтому DEMA1 = 2·EMA1 − EMA2 совпадает с y.
Все разборы дорожки · 43 разбора
- 1990Построение базовых линий доллара по ставкам, инфляции и остаткам
- 1990Построение номинального значения индекса по форвардным прибылям и подогнанной доходности
- 1990Построение номинальной цены индекса из прибыли и подобранной доходности
- 1990Ценовые траектории с фиксацией конечных точек — это не прогнозы
- 1990Построение полиномиальных сглаживателей методом наименьших квадратов
- 1991Темпы роста по конечным точкам против согласованности линейной регрессии
- 1991Вневыборочные проверки линейных аппроксимаций роста
- 1991Тренд как устойчивость, а не прямая линия
- 1991Квадратичный тренд, осциллятор остатков и вторичный календарь циклов
- 1991Смещение начала отсчёта времени и дивергенция остатков и цены на квадратичной аппроксимации методом наименьших квадратов
- 1991Линия тренда наименьших квадратов по упорядоченным ценам
- 1992Построение скринингов лог-линейного роста и надёжности
- 1992Построение лог-линейных базовых линий темпа роста
- 1992Максимум, минимум и закрытие следующей сессии по скользящей линейной регрессии
- 1993Проверка индексного мультипликатора цена/прибыль регрессией на краткосрочную ставку
- 1994Вложенный экспоненциальный ценовой фильтр с регрессионными начальными значениями
- 1994Построение двойного экспоненциального среднего из компенсации лага
- 1994Оценка денежной массы как линейной базовой модели опережающего индекса
- 1995Построение трендовых каналов методом наименьших квадратов
- 1995Holdout-проверки линейного базового прогноза годовых ставок по векселям
- 1995Проекционные полосы по наклонам регрессии максимумов и минимумов
- 1995Оценка скользящей средней по конечной точке метода наименьших квадратов на известном тестовом ряде
- 1996Построение концевой скользящей средней по прямой наименьших квадратов
- 1996Оценка согласованности траектории эквити с оверлеем k-ratio
- 1996Оценка month-end разрывов доходности для режимов рынка акций
- 1996Построение полос стандартной ошибки с сессионным индексом
- 1998Оценка линейных регрессионных базовых моделей для стоимостной оценки индекса
- 1998R-squared как двухсостоятельный трендовый фильтр на основе подгонки цена-время
- 2000Коррекция лага скользящего среднего второго порядка
- 2002Линия регрессии цены против беты при отслеживании индекса
- 2003Наклон регрессии с гейтом уверенности тренда по r-squared
- 2003Построение дивергенции finite-volume-element через сравнение наклонов
- 2004Построение дневного балла из регрессии, коррекции и объёма
- 2004Построение линий тренда методом наименьших квадратов по упорядоченным ценам
- 2007Цели пробоя прямоугольника выше высоты
- 2007Подтверждение ценового тренда наклоном регрессии и r-squared
- 2008Угол линейной регрессии, собранный как один тренд-фильтр
- 2010Свинг-машина с двумя состояниями из четырёх скользящих экстремумов
- 2016Оцените тесноту нефтяного комплекса перед дивергенцией или регрессией
- 2017Межрыночная дивергенция Nikkei–иена как кейс рыночного режима
- 2017Построение коэффициента Калмара и базовых линий линейной регрессии
- 2019Послойное построение pair-trade против управления по средней цене спреда
- 2020Наклон convolution, построенный из вложенной линейной регрессии